

本技术指南把新一代 VMware 平台整合在一个视角中:ESXi 虚拟化管理程序、作为控制平面的 vCenter Server,以及两种打包产品——VMware vSphere Foundation(VVF)和 VMware Cloud Foundation(VCF)——涵盖按核心许可、管理、身份、自动化、安全、性能和业务连续性。
本指南面向架构师、工程师、基础设施经理、售前团队和决策者。其中的容量示例是容量规划模型,而不是对任何特定工作负载的保证——必须依据 CPU、内存、延迟、IOPS、吞吐量、RPO 和 RTO 的实际测量结果重新计算。
关于本资料:内容整合自截至 2026 年 9 月 2 日可获得的 Broadcom/VMware 官方资料,包括 VMware Cloud Foundation 9.x 和新一代的 VMware vSphere Foundation。许可、促销指标、版本、支持和可用性可能发生变化——在购买或续订之前,请核对商务方案、产品指南(Product Guide)以及适用的合同条款。
概览与平台地图
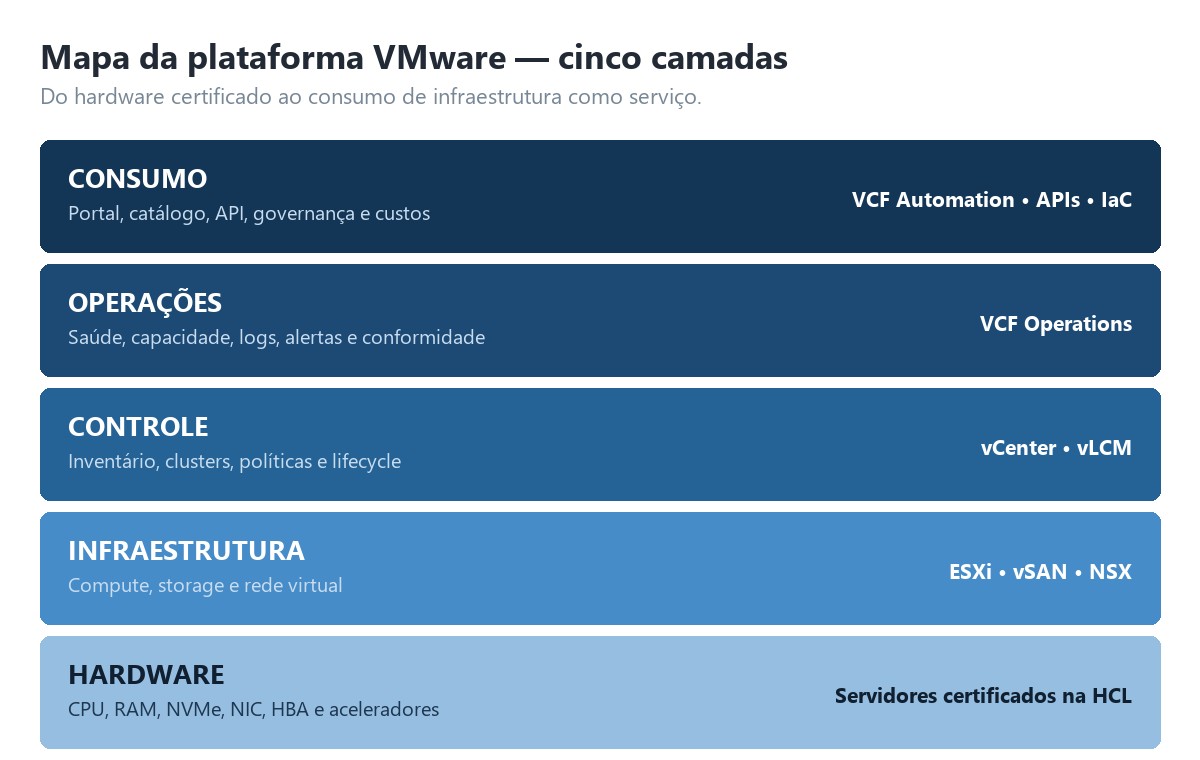
VMware 技术栈始于 ESXi,这是直接安装在服务器上的裸金属虚拟化管理程序。vCenter Server 增加了清单、策略、集群和分布式服务。VVF 打包了工作负载与 HCI 平台;VCF 则把整体扩展为全栈私有云,包含软件定义网络、自动化、集群群(fleet)管理、Kubernetes 和高级服务。
| 层 | 主要功能 | 典型技术 |
|---|---|---|
| 消费 | 门户、目录、API、治理和成本 | VCF Automation、API、IaC |
| 运营 | 健康、容量、日志、告警和合规 | VCF Operations |
| 控制 | 清单、集群、策略和生命周期 | vCenter、vLCM |
| 基础设施 | 计算、存储和虚拟网络 | ESXi、vSAN、NSX |
| 硬件 | CPU、内存、NVMe、网卡、HBA 和加速器 | 通过 HCL 认证的服务器 |
一句话决策:当核心需求是托管虚拟化和 HCI 时,选择 VVF;当目标是运营一个集成的、自动化的、多租户的、面向自助服务的私有云时,选择 VCF。
关键能力
| 能力 | 提供的价值 | 运维价值 |
|---|---|---|
| vMotion | 在宿主机之间热迁移虚拟机 | 无需计划内停机即可维护 |
| HA | 宿主机故障后自动重启 | 快速恢复 |
| DRS | 面向资源的负载均衡 | 更好的利用率,更少的热点 |
| vSAN | 基于策略的分布式存储 | HCI 与横向扩展 |
| VKS | 集成在控制平面中的 Kubernetes | 虚拟机和容器位于同一平台 |
| NSX / VPC | 软件定义网络与隔离 | 敏捷性与分段 |
| VCF Operations | 可观测性、容量和诊断 | 更短的解决时间 |
| VCF Automation | 目录、工作流、策略和 API | 自助服务式 IaaS |
三个运行平面
- 数据平面:虚拟机、容器、网络和卷运行在宿主机上。
- 控制平面:vCenter、管理器和控制器维护状态、清单和策略。
- 管理平面:Operations、Automation 和 Fleet Management 负责监控、交付和更新平台。
ESXi:虚拟化层
ESXi 提供工作负载隔离,并把 vCPU 调度到物理 CPU 上,同时管理内存、设备、驱动、数据存储和虚拟交换机。与通用操作系统相比,其设计缩小了攻击面,但它要求在固件、兼容性、加固和生命周期上保持纪律。
CPU 与 NUMA
- 依据观测到的需求而非理论最大值来规划 vCPU。过大的虚拟机可能需要等待更长的调度时间。
- 尽可能让关键虚拟机位于单个 NUMA 节点内;规模很大的虚拟机可能访问延迟更高的远端内存。
- 把 CPU Ready、Co-Stop、利用率、应用延迟和有效频率放在一起分析。
内存
- 避免触发 ballooning、压缩和交换的持续压力;宿主机交换是最后手段,会使延迟变差。
- 预留(Reservation)保证容量,限制(Limit)设定上限,份额(Share)定义争用时的优先级。
- 在计算集群容量时,要计入虚拟化管理程序开销、代理程序、vSAN 和基础设施服务。
虚拟网络
| 元素 | 用途 | 建议 |
|---|---|---|
| 标准 vSwitch | 独立宿主机或简单环境 | 适合小规模;按宿主机配置 |
| vSphere 分布式交换机 | 集中策略和高级功能 | 在企业级集群中更为可取 |
| 端口组 | VLAN 与逻辑策略 | 统一名称和 ID |
| vmkernel | 管理、vMotion、vSAN、NFS、FT | 分离流量并应用冗余 |
| 网卡绑定(NIC teaming) | 可用性与分流 | 与物理交换机一起验证故障切换 |
存储与生命周期
ESXi 可以通过 FC/iSCSI SAN、NFS 和 vSAN 使用 VMFS。选择时必须兼顾延迟、吞吐量、韧性、运维、备份集成和成本。虚拟机使用配置文件、虚拟磁盘、临时快照和日志——快照不能替代备份。在生命周期管理方面:验证硬件、固件、驱动和兼容性矩阵;在 vSphere Lifecycle Manager 中定义期望的镜像;先在试点组上测试;通过疏散工作负载进入维护模式;并在变更之后验证健康状况、网络、存储、告警和性能。
一个重要的指标:没有块大小、读写比、队列深度和延迟的 IOPS 是不完整的数字。请记录工作负载的完整特征。
vCenter Server:集中控制
vCenter Server Appliance 集中管理宿主机、虚拟机、模板、标签、权限、集群和任务。它不在虚拟机的 I/O 路径上:如果 vCenter 停止,工作负载会继续运行,但管理功能和依赖它的服务会受到限制。必须规划并测试它的恢复。
| 清单对象 | 职责 |
|---|---|
| 数据中心(Datacenter) | 集群、宿主机、网络和数据存储的逻辑容器 |
| 集群 | HA、DRS、EVC 和生命周期的作用域 |
| 资源池 | 分层的预留、限制和优先级 |
| 文件夹 | 组织结构和权限范围 |
| 标签 / 类别 | 用于策略、自动化和治理的元数据 |
| 内容库 | 模板、OVF、ISO 和内容分发 |
vCenter 高可用
使用原生的基于文件的备份(备份到外部目标)、集群 HA 以及一致的配置副本来保护该设备(appliance)。策略应当包括恢复设备、DNS、NTP、证书、紧急(break-glass)凭据和身份依赖。避免形成循环依赖,即恢复 vCenter 所需的唯一 DNS、AD 或软件仓库,恰恰位于受影响的环境之内而不可用。
管理反模式
- 日常运维使用 administrator@vsphere.local。
- 当运维人员只在单个文件夹或集群内工作时,却授予全局角色。
- 备份、监控和自动化使用同一个技术账户。
- 证书、DNS 和 NTP 没有有效期和可用性的监控。
- 只依赖设备快照,而不是可恢复的原生备份。
RBAC 原则:把企业组分配到正确范围内的最小角色上。避免直接给用户授权,也不要把 Administrator 用于日常任务。
许可:VCF 与 VVF
当前模式是按物理核心订阅。ESXi 宿主机上的每颗物理 CPU,最低按 16 个可授权核心计算,即使处理器的核心更少。所有运行该软件的物理核心都必须计入。商务条款、期限、支持和附加项必须在适用的方案中确认。
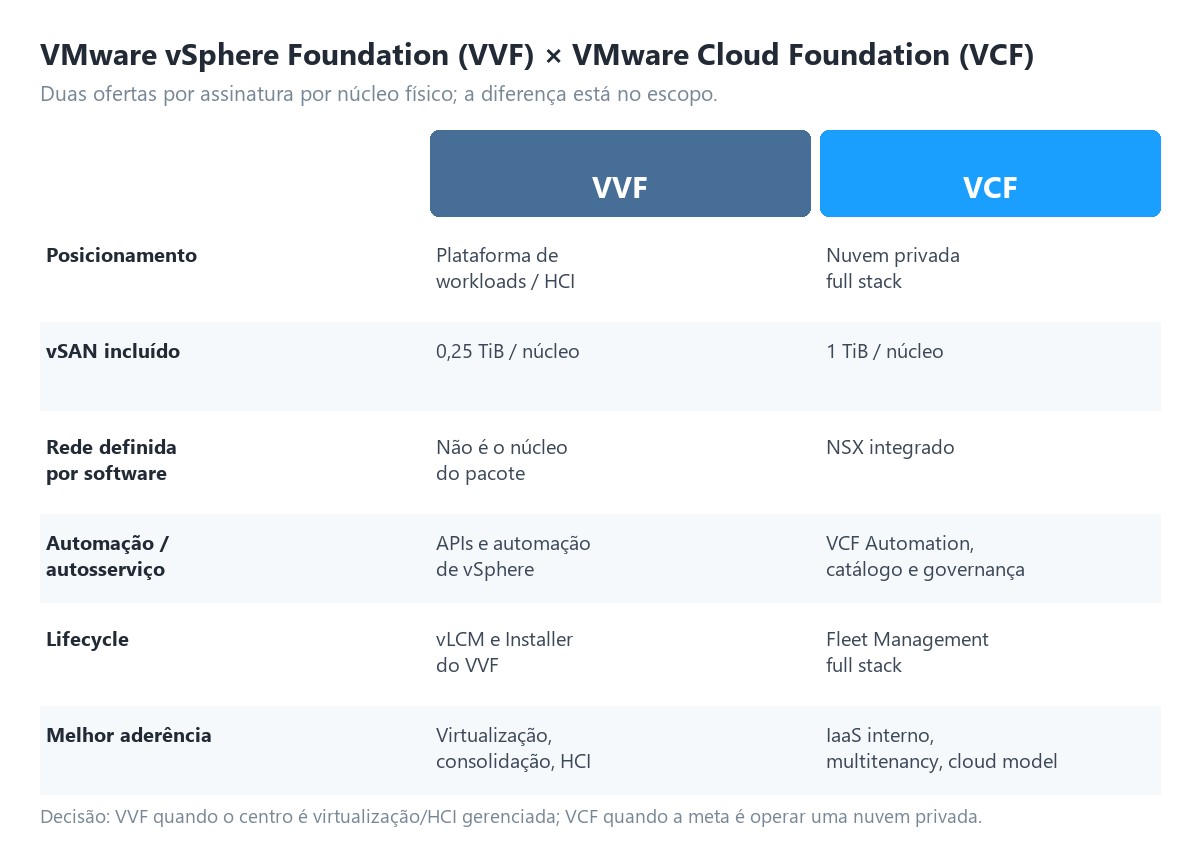
| 标准 | VMware vSphere Foundation(VVF) | VMware Cloud Foundation(VCF) |
|---|---|---|
| 定位 | 工作负载 / HCI 平台 | 完整的私有云平台 |
| 计算 | vSphere Enterprise Plus + vCenter Standard | 集成在 VCF 栈中的 vSphere |
| 包含的存储 | 每核心 0.25 TiB vSAN | 每核心 1 TiB vSAN |
| 软件定义网络 | 不是该产品包的核心 | 集成的 NSX |
| 运营 | 面向基础设施的 VCF Operations | 统一的全栈运营 |
| 自动化 / 自助服务 | vSphere API 和自动化;范围较小 | VCF Automation、目录和治理 |
| 生命周期 | vLCM 和 VVF Installer | Fleet Management 和全栈生命周期 |
| Kubernetes | 包含 VKS | 集成在私有云中的 VKS |
| 最适合 | 虚拟化、整合、HCI | 内部 IaaS、多租户、网络/安全和云运营模式 |
核心数计算公式
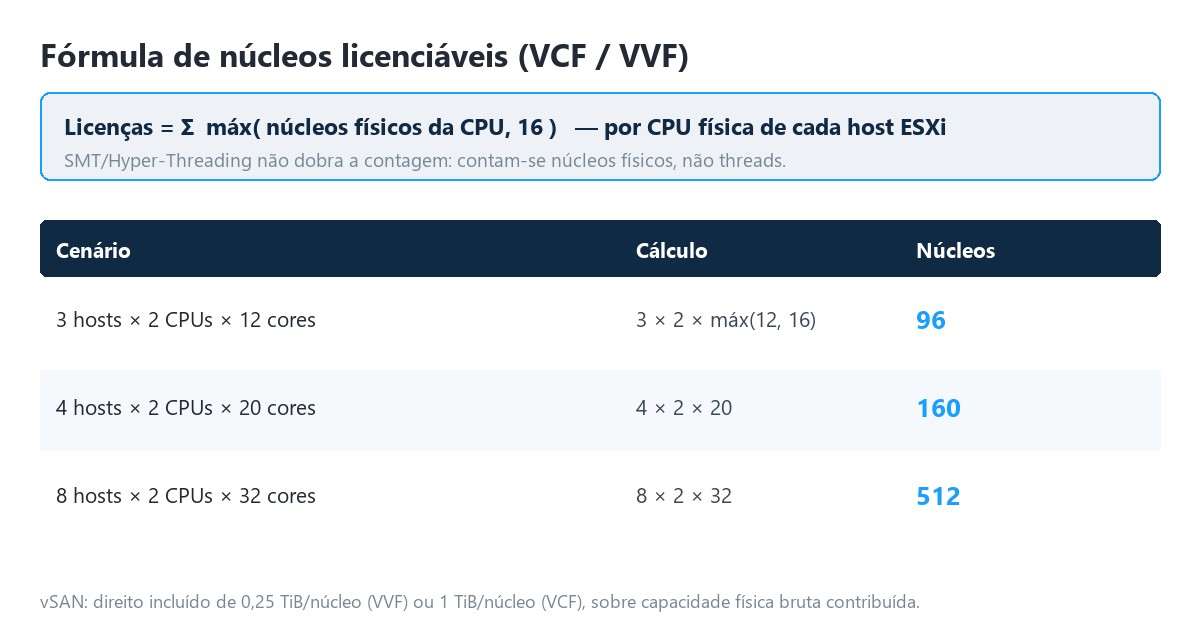
| 场景 | 计算 | 可授权核心数 |
|---|---|---|
| 3 台宿主机,每台 2 颗 CPU,每颗 12 核 | 3 × 2 × max(12, 16) | 96 |
| 4 台宿主机,每台 2 颗 CPU,每颗 20 核 | 4 × 2 × 20 | 160 |
| 8 台宿主机,每台 2 颗 CPU,每颗 32 核 | 8 × 2 × 32 | 512 |
vSAN 示例
一个集群有 4 台宿主机,每台 2 颗 20 核的 CPU:共 160 核。包含的权益在 VVF 下为 40 TiB,在 VCF 下为 160 TiB。如果集群为 vSAN 贡献 120 TiB 原始容量,则 VVF 需要额外 80 TiB;VCF 则已包含覆盖,具体取决于适用条款。许可考虑的是所贡献的原始物理容量,而不是应用策略和开销之后显示的可用空间。
VCF 9:许可管理
- 在 VCF Operations 中使用单一许可文件和统一视图,取代多个按组件的密钥。
- 联网或断网/物理隔离(air-gapped)模式。
- 在每个 180 天的窗口内提交使用情况并更新。
- 根据官方的 VCF 9 概览,没有使用数据时,现有工作负载会继续运行,但管理可能进入断连状态,并且无法再创建新的工作负载。
商务提醒:不要简单地用网上看到的“每核心价格”相乘来估算 TCO。要包括订阅期限、支持、附加项、超额的 vSAN、认证硬件、服务、税费、汇率、迁移和运维。
决策树
- 你是否只需要整合虚拟机、HA/DRS、vMotion、外部存储或简单的 HCI?先评估 VVF。
- 你是否需要集成的 NSX、VPC、自助服务、目录、治理和全栈生命周期?评估 VCF。
- 你是否需要很高的 vSAN 密度?比较 VVF 每核心 0.25 TiB 的权益与 VCF 每核心 1 TiB 的权益,以及附加项。
- 你是否需要 DR、高级安全、负载均衡或勒索软件防护?请检查高级服务;并非所有内容都属于核心部分。
管理仪表盘与可观测性
合适的仪表盘取决于所要回答的问题。vSphere Client 非常适合管理对象和任务。VCF Operations 关联健康、容量、成本、告警和趋势。VCF Automation 提供目录和消费治理。Fleet Management 梳理整个栈的生命周期。
| 仪表盘 | 主要用户 | 回答的问题 |
|---|---|---|
| vSphere Client | 虚拟化管理员 | 哪台虚拟机、宿主机、网络或数据存储需要处理? |
| VCF Operations | NOC、SRE、容量、FinOps | 哪里存在风险、浪费、异常或饱和? |
| VCF Automation | DevOps、平台团队、内部用户 | 如何申请并治理基础设施即服务? |
| Fleet Management | 平台团队 | 哪些实例、版本、凭据和更新构成了整个集群群(fleet)? |
| Business Services Console | 订阅管理 | 有哪些许可分配和消耗? |
推荐的运维仪表盘
| 模块 | 指标 |
|---|---|
| 可用性 | 断连的宿主机、HA 准入控制、没有冗余的虚拟机、硬件故障 |
| CPU | 使用率、Ready、Co-Stop、争用、频率和 NUMA |
| 内存 | Consumed、Active、balloon、压缩、交换和预留 |
| 存储 | 读写延迟、IOPS、吞吐量、拥塞、容量和重新同步(resync) |
| 网络 | 丢包、错误、饱和、故障切换、延迟和丢包率 |
| 容量 | 剩余天数、回收、增长、N+1/N+2 余量 |
| 体验 | 交付时间、工作流失败、事件和 SLO |
避免噪声:一个带有 200 条无人负责的告警的仪表盘只是装饰品。应整合相关联的症状,定义 SLO,并且仅在有明确行动时才生成工单——包含症状、可能原因、上下文和行动(运行手册、责任人、优先级和关闭标准)。
Active Directory、Entra ID 与 Azure
“Azure AD”已更名为 Microsoft Entra ID。vCenter 可以与企业身份提供商联合认证,实现 SSO 和现代策略。传统的 Active Directory 在本地环境中仍然重要。架构必须区分认证、授权和身份同步。
| 模型 | 何时使用 | 关注点 |
|---|---|---|
| 基于 LDAP 的 AD | 本地 AD 和经典集成 | TLS、证书、绑定账户以及对域控制器的依赖 |
| 集成 Windows 身份验证 | 特定的遗留场景 | 评估支持情况和产品方向 |
| AD FS | 联合认证已标准化为 AD FS | 服务器场的可用性、声明(claims)和证书 |
| Microsoft Entra ID | 云身份、MFA 和条件访问 | 企业应用、组、声明和应急账户 |
| Okta / PingFederate | 备选的企业 IdP | 组映射和证书周期 |
使用 Entra ID 的推荐流程
- 依据 vCenter 版本的文档,创建并授权企业应用。
- 在 vCenter 中配置身份提供商,并验证 URL、租户、client ID,以及适用时的证书/密钥。
- 把 Entra ID 组按最小权限映射到 vCenter 角色。
- 在 IdP 处应用 MFA 和条件访问,仅为恢复场景设置受控的例外。
- 测试登录、登出、过期、移出组、IdP 不可用以及紧急(break-glass)账户。
组示例
| 企业组 | 建议的角色 | 范围 |
|---|---|---|
| GG-VMW-Platform-Admins | 平台管理员 | vCenter/Datacenter,受限的组 |
| GG-VMW-VM-Ops | 自定义的虚拟机运维人员 | 生产文件夹/资源池 |
| GG-VMW-Auditors | 只读 + 事件 | Datacenter |
| GG-VMW-Backup | 备份产品所需的最小权限 | 必要的对象 |
| GG-VMW-Developers | 目录的使用者 | Automation 中的项目/组织 |
重要边界:把 vCenter 连接到 Entra ID 并不会“把 VMware 迁移到 Azure”——这只是身份联合。工作负载的扩展、DR 或在公有云中运行是另外的架构决策。至少保留两个受保护的、保存在保险库中的本地恢复账户,即使 DNS、AD、Entra ID 或外部连接失效,它们依然可用。
编排、自动化与 API
自动化执行任务;编排则协调多个任务、依赖、审批、策略、回滚和状态。在 VCF 中,目标是把基础设施变成带有护栏、可被消费的服务,而不仅仅是编写创建虚拟机的脚本。
| 层 | 工具 | 示例 |
|---|---|---|
| API / SDK | vSphere API、REST、Unified SDK | 创建虚拟机并查询清单 |
| CLI | PowerCLI、govc、esxcli | 报表和批量操作 |
| IaC | Terraform provider | 声明网络、虚拟机和策略 |
| 工作流 | VCF Automation Orchestrator | 审批、IPAM、DNS、CMDB 和回滚 |
| 目录 | VCF Automation | 蓝图/模板化与自助服务 |
| 客户机配置 | Ansible、脚本、cloud-init | 安装中间件并应用基线 |
最佳实践
- 幂等性:重复一个操作不得产生重复项或破坏状态。
- 机密:使用保险库、轮换和服务身份;绝不要把密码嵌入代码。
- 必填标签:owner、application、environment、data-class、backup-policy、cost-center 和 expiry。
- Git:对模板和工作流进行版本管理,通过拉取请求评审,并在各环境之间晋级。
- 可观测性:记录申请人、参数、步骤、返回结果和关联 ID。
- 回滚:区分可逆操作和破坏性操作,并要求相应的审批。
最小目录治理
| 控制 | 实施 |
|---|---|
| 配额 | 按项目、环境和资源类别设定限额 |
| 审批 | 仅当风险、成本或权限需要时 |
| 过期 | 实验环境的默认 TTL,以及续期前的复核 |
| 证据 | 责任人、工单、模板版本和工作流结果 |
| 退役 | 必要时做最终备份、撤销 DNS/IP,并在 CMDB 中核销 |
预期成果:一次标准化的申请可以从数天缩短到数分钟,但正确的 KPI 应包括成功率、合规性、返工、成本和恢复时间——而不仅仅是速度。
性能、容量规划与基准测试
性能必须端到端地度量。虚拟化管理程序可能是健康的,而数据库、网络或存储却限制了应用。应使用基线、百分位数和受控测试;平均值会掩盖峰值。
| 领域 | 指标 | 排查信号 |
|---|---|---|
| CPU | CPU Ready | 持续增长并伴随应用延迟 |
| CPU | Co-Stop | 宽 SMP 虚拟机在等待调度 |
| 内存 | Balloon / 交换 | 真实的压力或不合理的预留 |
| 存储 | 客户机/内核/设备延迟 | 定位队列和起限制作用的层 |
| 存储 | IOPS + 块大小 + 读写比 | 刻画需求,而不仅仅是容量 |
| 网络 | 丢包 / 错误 / 吞吐量 | 队列、MTU、驱动、上行链路或拥塞 |
| vSAN | 拥塞 / 重新同步 | 重建、策略或设备的影响 |
示例 1:通用虚拟化集群
四台宿主机,每台有 2 颗 24 核的 CPU 和 512 GB 内存。总计:192 核和 2,048 GB。为 N+1 故障预留一台宿主机后,在计入开销之前,大致的运营容量为 144 核和 1,536 GB。120 台虚拟机平均每台 2 vCPU 和 8 GB,则配置了 240 vCPU 和 960 GB。运营 vCPU:pCore 比例为 1.67:1,配置的内存占 N+1 容量的 62.5%。
| 项目 | 数值 | 解读 |
|---|---|---|
| CPU 总量 | 192 核 | 4 × 2 × 24 |
| N+1 CPU | 144 核 | 3 台宿主机可用 |
| 已配置 vCPU | 240 vCPU | 120 × 2 |
| N+1 的 vCPU:pCore 比例 | 1.67:1 | 对混合工作负载而言偏保守 |
| N+1 内存 | 1,536 GB | 计入开销之前 |
| 虚拟机内存 | 960 GB | 名义余量 576 GB |
示例 2:事务型存储
峰值需求为 80,000 IOPS,8 KiB 块,70% 读、30% 写。大致的逻辑吞吐量:80,000 × 8 KiB = 625 MiB/s。架构必须在延迟、设备故障和保护策略相匹配的情况下维持这一模式。还要测试重建/重新同步、快照和备份,因为仅有稳态并不能代表真实运行。
示例 3:厂商公布的目标
| 公布的指标 | 参考值 | 背景 |
|---|---|---|
| 端到端迁移 | 最高快 65% | DRS vMotion 并行处理 |
| 加密 vMotion 的源端 CPU | 最多降低 70% | 在兼容硬件上使用 Intel QAT 硬件卸载 |
| “巨型虚拟机”规模 | 最高 960 vCPU 和 16 TB 内存 | 当前 VVF 这一代的上限 |
| 4 路系统上的提升 | 最高 68% | 感知拓扑/NUMA 的调度 |
| vGPU vMotion | 最高快 6 倍 | 卸载和更高带宽的网络 |
| 排障 | 最多减少 60% 的工作量 | 全栈的主动诊断 |
小心“最高”:这些数值取决于硬件、版本和方法,不应相加来构建商业论证。请使用真实的负载特征和明确的验收标准进行 PoC——设定 SLO 和假设,采集生产基线,复现 CPU/内存/I/O/网络和并发,测试稳态、峰值、维护、故障和恢复,并比较百分位数,而不仅仅是平均值。
网络、存储、可用性与 DR
一个有韧性的平台,是从可接受的影响出发设计的,而不是从产品清单出发。先把关键性转化为 SLO、RPO 和 RTO,再选择 HA、复制、备份和 DR。
| 流量 | 功能 | 推荐做法 |
|---|---|---|
| 管理 | 宿主机和设备管理 | 冗余、ACL 和受控的管理访问 |
| vMotion | 内存/状态迁移 | 高带宽、低延迟和隔离 |
| vSAN | 集群 I/O 和重新同步 | 专用/逻辑网络、兼容性和余量 |
| 存储 IP | NFS / iSCSI | 多路径、队列、一致的 MTU,以及必要时的 QoS |
| 工作负载 | 应用和租户 | 分段、策略和可观测性 |
| 备份 / 复制 | 复制与 DR | 避免在关键窗口内与生产争抢资源 |
可用性
- N+1 可防范单台宿主机故障;在维护期间或关键集群中可能需要 N+2。
- HA 会重启虚拟机——并不等同于不中断的连续性。容错(Fault Tolerance)针对有自身要求的特定场景。
- 准入控制(Admission Control)必须预留故障转移容量;禁用它会掩盖风险。
- 拉伸集群(stretched cluster)可以缩短站点故障时的 RTO,但需要兼容的延迟、见证、网络和依赖关系设计。
备份与 DR
| 机制 | 可防范 | 不能取代 |
|---|---|---|
| HA | 宿主机故障 | 备份或站点级 DR |
| vMotion | 计划内维护 | 复制或备份 |
| 快照 | 短期变更 | 独立备份 |
| 复制 | 视设计而定的站点/阵列丢失 | 针对损坏/勒索软件的不可变副本 |
| 不可变备份 | 删除、损坏和勒索软件 | 连续性计划和恢复能力 |
| SRM / DR 编排 | 故障转移的排序与测试 | 目标端的基础设施和数据 |
真正的测试:只有经过一次恢复应用、身份、DNS、网络、机密和集成的测试之后,RPO 和 RTO 才是可信的——而不仅仅是把虚拟机开机。测试应涵盖:峰值时宿主机与存储路径同时故障、恢复期间 vCenter/DNS/NTP/IdP/KMS 不可用、部分隔离的站点丢失、勒索软件后的隔离恢复,以及回切到主站点。
安全、加固与运维
VMware 的安全涵盖硬件、ESXi、vCenter、网络、身份、虚拟机、自动化和供应链。目标是缩小攻击面、限制横向移动、检测配置漂移并快速恢复。
| 控制措施 | 实施 |
|---|---|
| 身份 | 联合认证、MFA、组、最小权限和紧急(break-glass)账户 |
| 管理平面 | 专用网络、跳板机 / PAM、ACL 和集中日志 |
| 宿主机 | Secure Boot、TPM 2.0、适用时的 lockdown、最小化服务 |
| 加密 | 最新的 TLS、虚拟机/vSAN 加密,以及高可用的 KMS |
| 网络 | 分段、分布式防火墙 / 依据许可的附加项 |
| 生命周期 | 补丁、HCL、期望的镜像和修复窗口 |
| 审计 | 事件、变更、登录、任务、配置和保留期 |
| 恢复 | 不可变备份、经过测试的恢复,以及位于故障域之外的凭据 |
Day 2 例行工作
- 每日:关键告警、故障转移容量、备份、硬件和失败的任务。
- 每周:异常、旧快照、孤立虚拟机、数据存储、重新同步和紧急补丁。
- 每月:容量预测、许可权益、特权账户、证书和抽样恢复。
- 每季度:DR 测试、RBAC 复核、固件/HCL、运行手册和依赖风险。
- 每年:架构、合同、TCO、硬件周期、SLO 和现代化计划。
参考架构与部署
模式 A——使用外部存储的 VVF
| 组件 | 设计 |
|---|---|
| 计算 | 4 至 8 台 ESXi 宿主机,N+1,CPU 兼容,内存依据特征配置 |
| 控制 | vCenter + VCF Operations |
| 存储 | 冗余的 FC/iSCSI SAN 或 NFS;多路径 |
| 网络 | vDS、冗余上行链路和隔离的 VLAN |
| 用途 | 虚拟机整合、ERP、数据库、中间件和 VDI |
模式 B——使用 vSAN 的 VVF HCI
| 组件 | 设计 |
|---|---|
| 集群 | 依据架构的技术最低要求;常见为 4 台以上宿主机以留出余量 |
| 存储 | 依据硬件和兼容性选用 vSAN ESA/OSA |
| 管理 | vCenter + Operations + SPBM |
| 扩展 | 增加节点,或依据支持情况使用存储集群 / 解耦(disaggregated)架构 |
| 用途 | 在一个集群中简化计算与存储的运维 |
模式 C——VCF 私有云
| 组件 | 设计 |
|---|---|
| 管理域 | 控制、管理和生命周期服务 |
| 工作负载域 | 按 SLA、硬件、租户或用途分开的集群 |
| 网络 | 依据架构使用 NSX、VPC、overlay 和网关 |
| 消费 | Automation、目录、项目、配额和策略 |
| 运营 | Operations、Fleet Management、日志和集成 |
| 用途 | 私有云、内部 IaaS、现代应用、Kubernetes 和私有 AI |
设计规则:不要从宿主机的数量开始。从工作负载、故障域、SLA、增长、兼容性、运维和许可开始——硬件是结果。各阶段为评估、HLD、LLD、构建、验证、迁移和运维。
迁移、成本与检查清单
| 策略 | 优势 | 风险 / 限制 |
|---|---|---|
| vMotion / 跨 vCenter | 兼容时中断较小 | 网络、延迟、版本、EVC 和存储 |
| HCX | 大规模迁移和网络延伸 | 设备(appliance)规划和吞吐量 |
| 备份 / 恢复 | 独立且可验证 | 复制窗口和时间 |
| 复制 | 降低 RPO 并实现受控割接 | 一致性和带宽 |
| 重建 | 使操作系统和配置现代化 | 需要更多的应用和测试工作 |
3 年 TCO 模型
| 类别 | 项目 |
|---|---|
| 软件 | VCF/VVF、额外的 vSAN、高级服务、备份、可观测性 |
| 硬件 | 宿主机、磁盘、交换机、光模块、SAN、支持和备件 |
| 设施 | 机架、电力、散热、空间和连接 |
| 服务 | 评估、部署、迁移、培训和支持 |
| 运维 | 人员、值班、补丁、容量、审计和事件 |
| 风险 | 停机、锁定(lock-in)、延期、返工和过时 |
VVF × VCF 决策检查清单
- 已完成对宿主机、插槽、核心数和 vSAN 原始容量的盘点。
- 已按关键性、RPO、RTO、CPU、内存、I/O、网络和增长对工作负载分类。
- 已验证对 NSX、微分段、VPC 和多租户的需求。
- 已验证对目录、自助服务、配额、费用分摊(chargeback)和 API 的需求。
- 高级服务已与核心部分区分,并在方案中得到确认。
- 3 至 5 年的 TCO,包含硬件、迁移、运维、支持、汇率和税费。
- PoC 度量百分位数、故障、维护、备份和恢复。
- 已记录退出/迁移计划和数据可移植性。
基本术语表
| 术语 | 简短定义 |
|---|---|
| ESXi | vSphere 平台的裸金属虚拟化管理程序。 |
| vCenter | 用于管理、清单和策略的中心平面。 |
| VCF | VMware Cloud Foundation;全栈私有云平台。 |
| VVF | VMware vSphere Foundation;工作负载 / HCI 平台。 |
| vSAN | 集成在 vSphere 中的软件定义存储。 |
| NSX | 软件定义网络与安全。 |
| VKS | vSphere Kubernetes Service。 |
| DRS | 分布式资源调度器(Distributed Resource Scheduler)。 |
| HA | 高可用(High Availability);故障后自动重启。 |
| SPBM | 基于存储策略的管理(Storage Policy-Based Management)。 |
| RPO | 最大可接受的数据丢失量。 |
| RTO | 恢复服务的最长时间。 |
| HCL | 硬件/软件兼容性列表。 |
| EVC | 实现宿主机之间迁移的 CPU 兼容性。 |
| NUMA | 多处理器服务器中的非统一内存架构。 |
结论
ESXi 和 vCenter 仍然是企业虚拟化的稳健基础。VVF 把这一基础组织成现代的工作负载与 HCI 平台。VCF 则增加了私有云运营模式:集成的网络、全栈管理、集群群生命周期、自动化、自助服务和治理。正确的选择不是“谁的功能更多”,而是哪一个适合组织的运营模式、风险和 TCO。
实用建议:对于有中心化团队并使用外部存储的传统虚拟机环境,VVF 往往是自然的起点。要提供内部 IaaS、多租户、Kubernetes、端到端自动化和软件定义网络,VCF 往往能减少手工集成——前提是组织采用平台化的流程,并且真正使用这些能力。
官方来源与延伸阅读
本资料依据 Broadcom/VMware 官方来源编写,截止日期为 2026 年 9 月 2 日。请务必查阅适用的发行说明、互操作性矩阵、VMware 兼容性指南(VMware Compatibility Guide)、产品指南以及当前的商务方案。
- Licensing for VMware Cloud Foundation 9.0
- VMware Cloud Foundation 9.x — Data Sheet
- VMware vSphere Foundation — Data Sheet
- Feature Comparison & Upgrade Paths: VCF and VVF
- Counting Cores for VCF/VVF and TiBs for vSAN — Broadcom KB 313548
- VCF 9.0 Product Subscription and Licensing
- vCenter identity federation with Microsoft Entra ID
- Performance Best Practices for VMware vSphere 8
- Operations in VMware Cloud Foundation 9.0
- Five reasons to upgrade from VVF to VCF
编者注
名称、品牌和产品归其各自所有者所有。数值化的容量和性能示例是出于教学目的整理的,不构成报价、实验室基准测试或许可咨询——最终的容量规划和经济性取决于每个项目的实际硬件、SLA 和商务合同。
NGG Tech:云 • 数据中心 • 裸金属 • 存储 • 支持 • 安全